Kann man auf der Hetzner Cloud ein ausfallsicheres System mit kleinem Budget bauen?
von Dominik Zalewski ·
Einleitung
Stell dir vor, wir wollen das einfachstmögliche System bei Hetzner betreiben:
Anfrage --> Anwendung --> DatenbankAuf einem dedizierten Server (Bare Metal) könnte der Baustein so aussehen:
Maschine  <-- Anfrage
  anwendung --> datenbank --> RAID
In einem echten Produktionssystem laufen entweder viele Anwendungen (oder Microservices), oder es ist ein mandantenfähiges System. Daraus wird dann eher so ein Aufbau:
Maschine1  <-- Anfrage
  anwendung_11 --> datenbank_11 --> RAID
  anwendung_12 --> datenbank_12 --> RAID
  ...
  anwendung_1n --> datenbank_1n --> RAID

Maschine2  <-- Anfrage
  anwendung_21 --> datenbank_21 --> RAID
  anwendung_22 --> datenbank_22 --> RAID
  ...
  anwendung_2n --> datenbank_2n --> RAID

...

Maschine_k
Machen wir jetzt dasselbe für die Hetzner Cloud:
VM_1  <-- Anfrage
  anwendung_11 --> datenbank_11 --> volume_11
                                +-> backupVolume_11
VM_2  <-- Anfrage
  anwendung_12 --> datenbank_12 --> volume_12
                                +-> backupVolume_12
...
VM_m  <-- Anfrage
  anwendung_1m --> datenbank_1m --> volume_1m
                                +-> backupVolume_1m
In der Cloud kommt ein Backup-Volume dazu, weil das der einzige Weg ist, den ich kenne, um die Datenbank aus einem Backup wiederherstellbar zu halten, falls das Live-Volume verloren geht.
Das Bild sieht so aus, als hätten wir die Ausfallsicherheit verbessert. Auf dedizierter Hardware hatten wir k
physische Maschinen, von denen jede ausfallen und einen Teil des Systems mitreißen konnte. In der Cloud sieht es nach
m unabhängigen Bausteinen aus: Wenn VM_1 ausfällt, hat das keinen Einfluss auf die Verfügbarkeit von VM_2.
Genau das habe ich geglaubt, als ich meine erste Migration in die Hetzner Cloud gemacht habe. Nach ein paar Monaten im Produktivbetrieb kamen dann kryptische E-Mails mit diesem Betreff:
Betreff: Wartungsarbeiten an Volume Pool 791
Inhalt:
...
Die folgenden Produkte sind betroffen:
prod Cloud Volume #9000025 volume_11
prod Cloud Volume #9000026 backupVolume_11
prod Cloud Volume #9000027 volume_12
prod Cloud Volume #9000028 backupVolume_12
...
prod Cloud Volume #9000029 volume_1p
prod Cloud Volume #9000030 backupVolume_1p
...
und als das Wartungsfenster kam, waren anwendung_11 bis anwendung_1p weg.
Das brachte mich ins Grübeln, ob mein mentales Modell des Systems überhaupt stimmt.
Die rote Pille
Ziemlich schnell kam ich zu dem Schluss: Die Hetzner Cloud ist logisch betrachtet aus denselben Bausteinen gebaut wie Hetzner Robot, also aus Hardware und Software. Der einzige logische Unterschied liegt in der Aufteilung der Verantwortung, also darin, welcher Teil mir gehört und welcher dem Anbieter. Meine Recherche ergab folgende Architektur:
nbg1-cloud1-leaf43  <-- Anfrage
  Node 41207
    VM_1
      anwendung_11 --> datenbank_11 -------+
  ...                                      |
    VM_p                                   |
      anwendung_1p --> datenbank_1p -------+
                                           |
nbg1-cloud1-leaf41  <----------------------+
  Volume Pool 791
    volume_11
    backupVolume_11
    ...
    volume_1p
    backupVolume_1p

fsn1-cloud2-leaf45  <-- Anfrage
  Node 58314
    VM_p+1
      anwendung_1p+1 --> datenbank_1p+1 ---+
  ...                                      |
    VM_m                                   |
      anwendung_1m --> datenbank_1m -------+
                                           |
fsn1-cloud2-leaf86  <----------------------+
  Volume Pool 181
    volume_1p+1
    backupVolume_1p+1
    ...
    volume_1m
    backupVolume_1m
Die entscheidende Beobachtung, die meine Sicht verändert hat: Ein Volume ist nicht das Gegenstück zu einem RAID im Robot-System. Es ist keine Platte. Es ist ein eigener Netzwerkaufruf an einen komplexen Ceph-Cluster. Auch wenn man sagen könnte, beides sei I/O und damit irgendwie gleichwertig - im Fehlerfall verhalten sie sich nicht gleich.
Damit stand die eigentliche Frage im Raum: Können wir das ausfallsicher machen?
Die Architektur der Verfügbarkeit
Zuerst der Versuch einer Erklärung, was Leaves und Pools sind. Nodes lasse ich vorerst außen vor, weil sie die Volumes nicht betreffen. Leaves sind Netzwerkkomponenten, die den Zugang zu den Volume Pools steuern. Das ist eine 1:n-Beziehung. In den Volume Pools liegen dann die einzelnen Volumes.
Daraus ergibt sich diese Auswirkung, je nachdem, auf welcher Ebene gewartet wird.
| Ebene | Zuständig | Umfang | Spielraum |
|---|---|---|---|
| Leaf | Anbieter | Alle Volumes in allen Pools hinter diesem Leaf | Ausfallzeit vom Anbieter vorgegeben |
| Volume Pool | Anbieter | Alle Volumes in diesem einen Pool | Ausfallzeit vom Anbieter vorgegeben |
| Volume | Kunde | Ein einzelnes Volume | vom Kunden geplant |
Wenn du aus der Robot-Welt kommst, ist die nächstliegende Entsprechung für Leaf/Volume Pool ein RAID auf einem dedizierten Server, das gewartet werden muss und wofür die ganze Maschine heruntergefahren wird. Nach der in der Einleitung gezeigten Architektur sind damit viele Microservices (oder viele Kundensysteme, wenn es mandantenfähig ist) nicht erreichbar.
Jetzt zur Verfügbarkeit in der Praxis. Hetzner hat ein SLA1, samt Entschädigungsmöglichkeit2, leider aber nur für vServer. Das SLA nimmt außerdem jede geplante Wartung aus, die früher als 24 Stunden vor der Ausfallzeit angekündigt wurde.
Das Folgende ist also nur ein Gedankenexperiment, denn das SLA deckt weder Volumes noch geplante Wartung ab (theoretisch könnte der Anbieter Wartung für einen ganzen Monat ankündigen und das SLA wäre trotzdem erfüllt). Wenn wir aber einmal annehmen, die Volumes stünden unter einem SLA von 99,9 % und geplante Wartung zählte weiterhin als Ausfall, dann sieht die Praxis für meine Flotte so aus. Die Migration von Robot (dediziert) in die Hetzner Cloud begann im März 2025 und lief über die folgenden sechs Monate. Hier die Volume-Ausfälle, die ich erlebt habe, jeweils mit der Flottengröße zu diesem Zeitpunkt (angekündigte Wartungen, die nur die Performance beeinträchtigen, sind nicht enthalten).
| Monat | Art | schlechteste Volume-Verfügbarkeit | längster Ausfall | Volumes < 99,9 % | Prod-Flotte | Anteil | Einheit |
|---|---|---|---|---|---|---|---|
| 2025-09 | ungeplant | 99,8750 % | 54 Min | 5 | 151 | 3 % | Pool 632 |
| 2026-02 | ungeplant | 99,8661 % | 54 Min | 5 | 179 | 3 % | Pool 918 |
| 2026-03 | geplant | 99,8656 % | 60 Min | 26 | 185 | 14 % | Leaf nbg1-cloud1-leaf92 |
| 2026-04 | geplant | 99,8611 % | 60 Min | 37 | 187 | 20 % | Leaf nbg1-cloud1-leaf68 |
| 2026-05 | geplant | 99,8656 % | 60 Min | 29 | 190 | 15 % | Leaf hel1-cloud1-leaf98 |
| 2026-06 | ungeplant | 99,6759 % | 140 Min | 7 | 194 | 4 % | Pool 689 |
Die Verfügbarkeit der vServer bleibt in diesem Artikel außen vor, weil ich beobachtet habe, dass die Volume-Verfügbarkeit den größten Einfluss auf die Verfügbarkeit der Flotte hat. Interessant dabei: Volumes tauchen im SLA überhaupt nicht auf, tragen aber am meisten zur Verschlechterung bei. Die zweite Beobachtung: Wenn der Anbieter ein Wartungsfenster von einer Stunde ankündigt, heißt das bereits, dass die Verfügbarkeit nicht über 99,9 % bleiben kann (die Grenze liegt bei rund 43 Minuten im Monat, je nach Anzahl der Tage).
Rückblick auf den Systementwurf
Beim ursprünglichen Entwurf hatte ich nur die Informationen, die der Anbieter veröffentlicht hat3.
Jeder Datenblock wird auf drei verschiedenen physischen Servern gespeichert (dreifache Replikation).
Damals hielt ich das für deutlich haltbarer als das übliche RAID-1 auf dedizierten Servern. Mein Gedankengang ging ungefähr so:
| Zustand | dediziert | Cloud |
|---|---|---|
| clean | [UU] | [UUU] |
| degraded | [U_] | [UU_] |
| hanging | n/a | [U__] |
| failed | [__] | [___] |
Erst später habe ich gemerkt, dass der Zustand “hanging” der ist, in dem das Volume nicht mehr antwortet. Die Daten liegen weiterhin gespeichert vor, nur erreichbar sind sie nicht mehr. Was ich damals nicht bedacht habe, ist der Verfügbarkeitsfaktor, der in der Dokumentation nicht klar dasteht. Dieses Volume liegt auf drei getrennten Maschinen, auf denen jeweils Netzwerk, Mainboard oder Platte ausfallen können. Und es ist eine geteilte Umgebung - auf diesen Maschinen liegen viele Volumes verschiedener Kunden.
Um die Widerstandsfähigkeit meines Entwurfs besser zu verstehen, wollte ich herausfinden, wie meine rund 200 Volumes über den gesamten Ceph-Cluster verteilt sind, den Hetzner betreibt. Die Platzierungszahlen ab hier zählen alle 199 Volumes, also auch die Handvoll Infrastruktur-Volumes, die in der Spalte Prod-Flotte oben fehlt. Es gibt keine API, die die Leaf- oder Volume-Pool-ID zurückgibt. Später habe ich entdeckt, dass sich ein Teil dieser Information aus den Wartungs-E-Mails des Anbieters ableiten lässt, weil sie Interna wie Cloud-Leaf-Namen oder Volume-Pool-IDs durchscheinen lassen. Am meisten gebracht hat aber, den Support zu kontaktieren und einfach danach zu fragen. Ich war überrascht, wie leicht und wie schnell ich die Information zurückbekommen habe. Ich habe die Anfrage am Freitag um 17:43 Uhr rausgeschickt und die vollständige Liste am Montagmorgen um 7:39 Uhr bekommen. Die offizielle Servicezeit für allgemeine Anfragen ist Mo-Fr 8:00 bis 18:00 Uhr, mitteleuropäische Zeit4, wörtlich genommen habe ich die Antwort also (je nach Rechenweise) entweder in 17 Minuten oder in -4 Minuten bekommen. Mir gefällt die zweite Lesart besser, denn es war das erste Mal, dass sich “brauche ich seit gestern” machbar angefühlt hat.
Sofort habe ich Pivot-Tabellen über die Daten gelegt, um so eine Aufschlüsselung zu bekommen:
- nach der Größe der Volume Pools sortieren,
- Zeile für Zeile über diese Volume Pools gehen,
- zählen, wie viele Volumes betroffen sind, kumuliert bis zur nächsten Zeile.
| Leaf | Pool-ID | Volumes | % | kumuliert % |
|---|---|---|---|---|
| nbg1-cloud1-leaf41 | 791 | 19 | 9,5 % | 9,5 % |
| hel1-cloud1-leaf87 | 379 | 18 | 9,0 % | 18,6 % |
| fsn1-cloud2-leaf86 | 181 | 15 | 7,5 % | 26,1 % |
| fsn1-cloud2-leaf53 | 689 | 14 | 7,0 % | 33,2 % |
| nbg1-cloud1-leaf73 | 931 | 14 | 7,0 % | 40,2 % |
| fsn1-cloud2-leaf86 | 8 | 9 | 4,5 % | 44,7 % |
| hel1-cloud1-leaf25 | 547 | 7 | 3,5 % | 48,2 % |
| nbg1-cloud1-leaf59 | 596 | 7 | 3,5 % | 51,8 % |
Die Aufschlüsselung ist ziemlich frustrierend. Es zeigt sich, dass 50 % der Volumes in nur 8 Pools liegen, der schlimmste ist Pool 791 mit 19 Volumes. Das heißt: Fällt Pool 791 aus, gehen alle 19 Systeme mit. Das sind 10 % der Flotte.
Am deprimierendsten ist aber der Einfluss der anbieterseitigen Wartung von März bis Mai 2026 auf die Verfügbarkeit. Damals hat Hetzner Cloud Leaves getauscht, und da fällt noch mehr auf einmal aus. Die folgende Tabelle berücksichtigt keine echten Verfügbarkeitsdaten, sie wertet nur aus, wie viel eine solche Wartung überhaupt mitnimmt. Dieselbe Pivot-Tabelle wie bei den Volume Pools, nur eine Ebene höher, auf Cloud-Leaf-Ebene.
| Leaf | Pools | Volumes | % | kumuliert % |
|---|---|---|---|---|
| fsn1-cloud2-leaf86 | 2 | 24 | 12,1 % | 12,1 % |
| nbg1-cloud1-leaf41 | 1 | 19 | 9,5 % | 21,6 % |
| hel1-cloud1-leaf87 | 1 | 18 | 9,0 % | 30,7 % |
| fsn1-cloud2-leaf53 | 2 | 16 | 8,0 % | 38,7 % |
| hel1-cloud1-leaf25 | 4 | 16 | 8,0 % | 46,7 % |
| nbg1-cloud1-leaf73 | 2 | 15 | 7,5 % | 54,3 % |
Jetzt reichen nicht 8 Volume Pools, sondern schon 6 Cloud Leaves, um über 50 % der Flotte lahmzulegen, und der schlimmste Fall sind nicht 19 Volumes in einem einzelnen Volume Pool, sondern zwei Volume Pools hinter einem Leaf mit zusammen 24 Volumes. Was auf einen Schlag ausfällt, wächst damit von 10 % auf 12,1 %.
Genauere Analyse
Mit der Pivot-Tabelle bekommt man den schlimmsten Fall leicht heraus. Als Ingenieure wollen wir aber genauer verstehen, wo wir stehen und wie weit es bis zum Idealzustand ist. Also habe ich ein Werkzeug gebaut, das eine feinere Analyse erlaubt, und es in die schon vorhandene Open-Source-Gelkao CLI eingebaut.
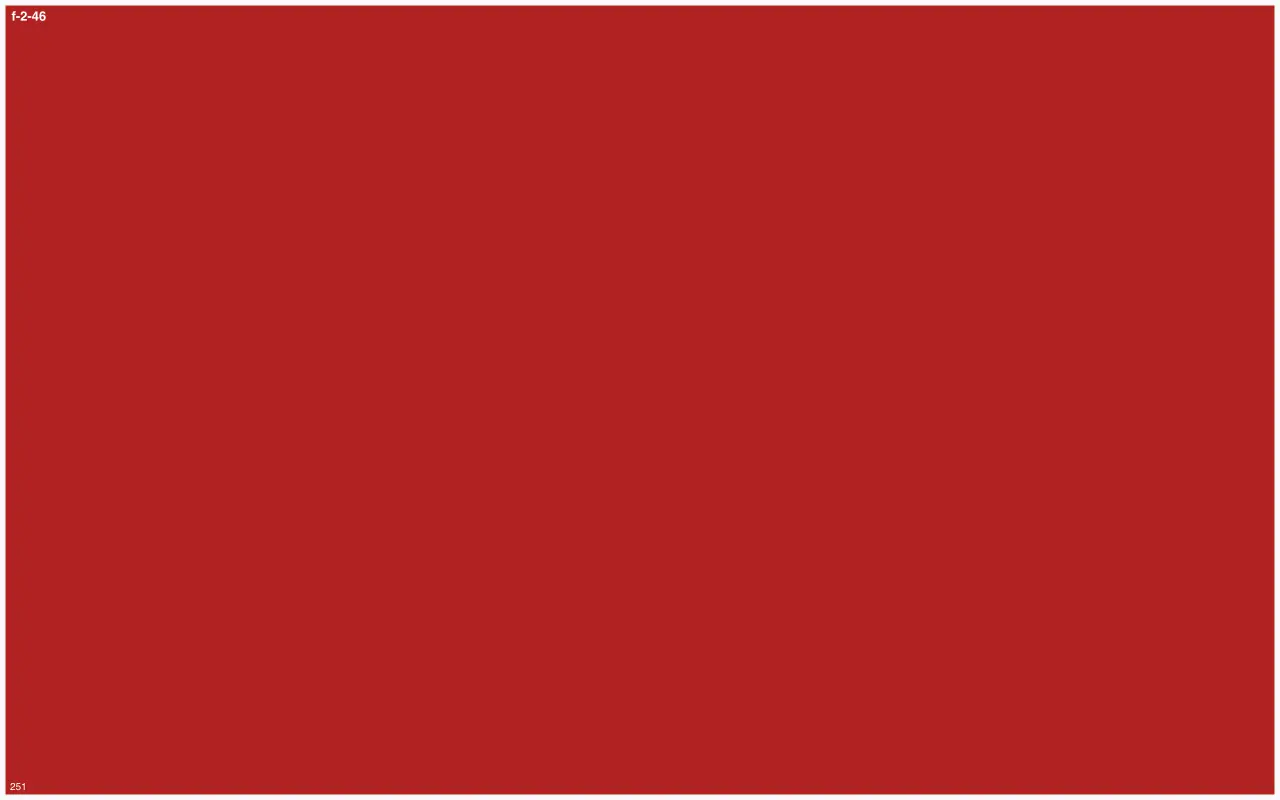
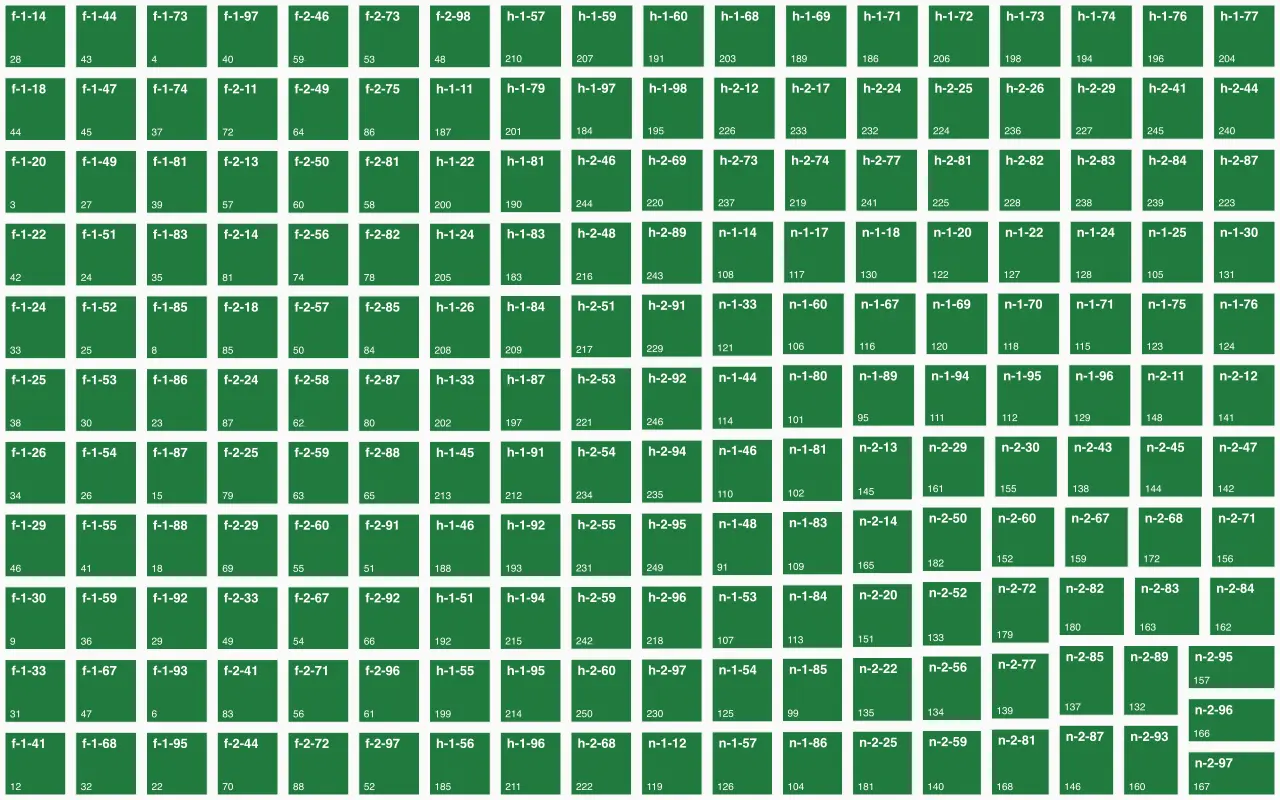
Zuerst zu den beiden Extremen. Sie sind unten abgebildet. Ein komplett rotes Rechteck ist der Fall, in dem alle Volumes hinter demselben Cloud Leaf und in einem einzigen Volume Pool liegen. Ein komplett grünes Rechteck ist der Fall, in dem jedes Volume in einem eigenen Volume Pool und hinter einem eigenen Cloud Leaf liegt. Das heißt natürlich nicht, dass das Volume dort allein liegt. Es können andere Hetzner-Kunden Volumes im selben Volume Pool oder hinter demselben Cloud Leaf haben.
Die echte Flotte liegt als Bild zwischen diesen beiden Extremen. Um aber überhaupt sichtbar zu machen, wie weit weg vom Ideal, brauchen wir eine Kennzahl aus dem Geschäft. Ich habe im Unternehmen gefragt, die Antwort war 10. Die Frage lautete:
Wie viele gleichzeitige Volume-Ausfälle verträgt unser Geschäft gerade nicht mehr?
Mit dieser Zahl in der Hand konnte ich anschaulich zeigen, wie weit wir vom Idealfall weg sind. Die Flotte hat genau 8 Volumes von 199, die in einem eigenen Volume Pool liegen, jedes hinter einem anderen Cloud Leaf. 4 % sind also bereits im bestmöglichen Zustand. Auf dem Bild sieht man leicht: Würden wir den grünen Anteil nehmen und über das ganze Bild kacheln, bräuchte es etwa 4 Spalten und 5 Zeilen, also 20 Kacheln. Eine einzelne Kachel, das ist die gesamte grüne Fläche, sind dann rund 5 % - nach bloßem Augenmaß eine fast exakte Schätzung.
Genauso beim roten Rechteck oben links. Erinnere dich: Das schlimmste Cloud Leaf hatte 12,1 % der Flotte. Dieses zweifarbige Rechteck oben links nimmt die halbe Höhe und grob 20-25 % der Breite ein. Optisch belegt es also 10-12,5 % der Grafik. Das passt fast genau zu den 12,1 % aus dem letzten Abschnitt.
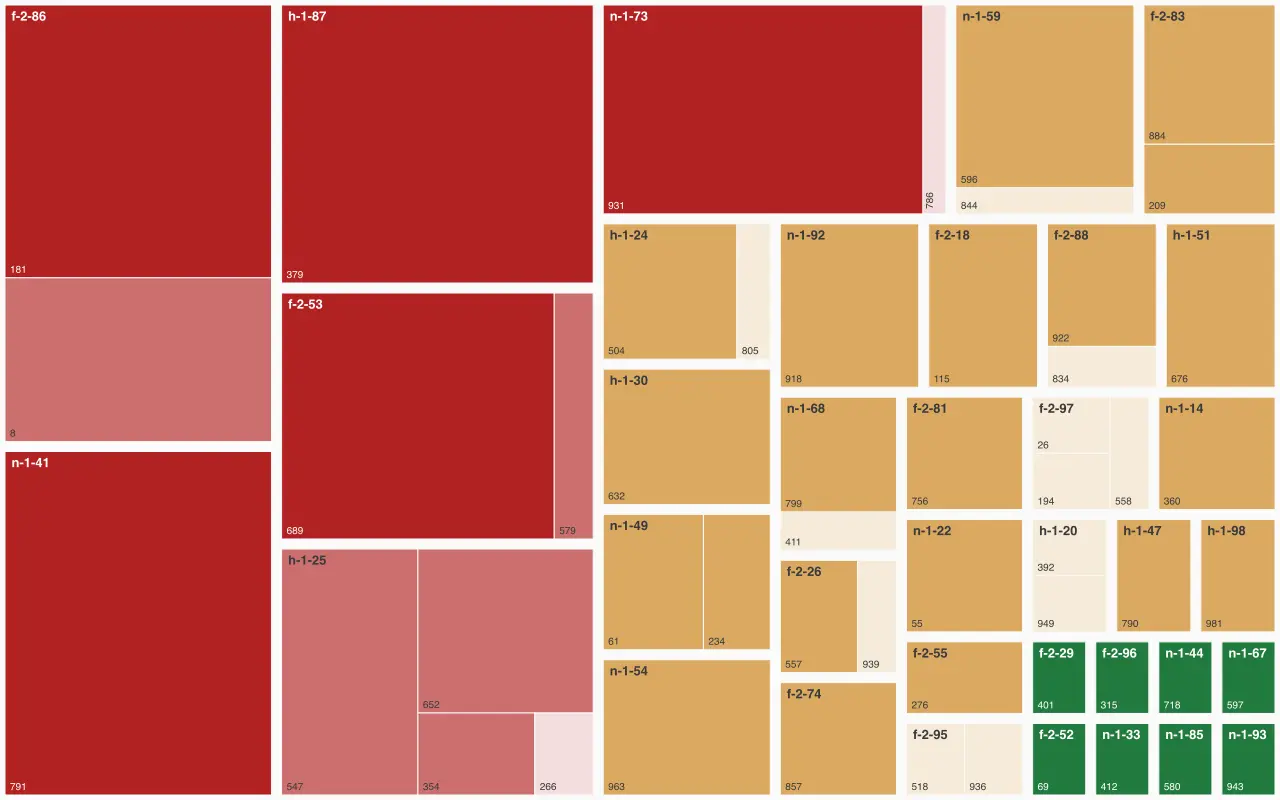
Damit ist klar, was die großen Rechtecke sind: Cloud Leaves. Sie tragen auch die Ampelfarben. Ein Leaf mit:
- 1 Volume ist grün
- 2-9 Volumes ist gelb (10 ist die oben eingeführte Schmerzgrenze des Geschäfts)
- 10 und mehr Volumes ist rot
Jetzt sehen wir uns an, wie die Volume Pools kodiert sind. Ein Beispiel, an dem man es gut sieht, ist f-2-95 unten
rechts, mit den Volume Pools 518 und 936. Jeder dieser Volume Pools enthält genau ein Volume, deshalb sind sie
in einem helleren Gelb. Das ist der günstige Fall, bei dem der Ausfall eines Volume Pools den geringstmöglichen
Einfluss auf das System hat: Ein Volume Pool fällt aus, ein Volume ist weg. Jede dunklere Schattierung eines
Volume-Pool-Rechtecks heißt, dass dieser Volume Pool mehr als ein Volume enthält (grün ausgenommen).
Wenn du dir die zweite Tabelle aus dem vorherigen Abschnitt genauer ansiehst, steht in der letzten Zeile kumuliert 54,3 %. Und hinter jedem dieser Leaves liegen 10 oder mehr Volumes. Es ist kein Zufall, dass die Grafik genau dieselbe Geschichte erzählt. Das Rot belegt ungefähr die Hälfte des Bildes.
Was sagt mir die Grafik also besser als jede Pivot-Tabelle? Zum Beispiel sehe ich auf einen Blick, dass bei der Hälfte meiner Flotte der Ausfall eines einzelnen Cloud Leaf mehr als 10 Volumes mitnimmt (das Rot). Rund 4 % stehen perfekt (das Grün). Und es gibt einen Teil, der auf lange Sicht vielleicht problematisch ist, aber keine unmittelbare Gefahr für das Geschäft (Gelb) - technische Schulden wäre wohl ein guter Name für den gelben Teil.
Ich will die Grafik nicht überverkaufen, aber nach meinem Verständnis lässt sich die Ausfallsicherheit einer Flotte damit einer nicht technischen Person im Unternehmen deutlich leichter erklären als über eine Pivot-Tabelle.
Anwendungsfall: Live/Backup
Im Hetzner Forum5 wird schon nach genau diesem Fall gefragt. Die Datenbank ist so konfiguriert, dass die Live-Daten auf einem Volume und die Backup-Daten auf einem getrennten Volume liegen. Beide Volumes hängen an derselben Maschine. Der Cloud-Support von Hetzner ist nicht rund um die Uhr besetzt. Innerhalb der europäischen Geschäftszeiten antwortet er ziemlich schnell, aber wenn dein System spätabends oder nachts steht, musst du bis zum nächsten Morgen warten.
Firmen, die auf der Hetzner Cloud hosten, haben in der Regel SLAs mit ihren Endkunden. In diesen SLAs steht eine harte Frist für die Wiederherstellung. Wird ein Live-Volume also etwa um 22:00 Uhr als nicht erreichbar erkannt und es gibt ein Verfahren, aus einem Datenbank-Backup in weniger als einer Stunde wiederherzustellen, dann wäre allen gedient. Liegen aber beide Volumes (live und Backup) im selben Pool oder hinter demselben Leaf, fallen sie gemeinsam aus. Das schlägt direkt auf das SLA durch, das sich im geschilderten Fall nicht mehr einhalten lässt. Nur Hetzners Personal kann das System wiederherstellen, und das passiert erst am nächsten Morgen, also zwölf Stunden später - damit ist das SLA mit dem Endkunden gebrochen.
Der derzeitige Behelf sieht so aus:
- Über mehrere Tage verteilt ein paar Volumes anlegen
- Ein Support-Ticket bei Hetzner Cloud aufmachen und nach der Leaf-/Volume-Platzierung dieser Volumes fragen
- Die Volumes auswählen, die NICHT hinter demselben Leaf oder schlicht NICHT im selben Pool liegen (je nach Vorliebe), und sie für die Live-Daten und das Backup nehmen
- Alle anderen Volumes wieder löschen. Die Laufzeit zahlst du trotzdem, aber da Volumes vergrößert werden können, sind diese Kosten meist zu vernachlässigen, wenn du für ein paar Tage die kleinsten 10-GB-Volumes nimmst
Der Behelf hat folgende Nachteile. Es steckt eine Schleife darin. Wenn die Antwort von Hetzners Support kommt und sich herausstellt, dass alle Volumes hinter demselben Leaf oder im selben Pool liegen, fängst du von vorne an. Deshalb oben “über mehrere Tage verteilt”. Ich habe meine historische Volume-Erzeugung ausgewertet, und es zeigt sich: Volumes, die zur selben Zeit angelegt wurden, landeten überwiegend im selben Volume Pool. Meine Erfahrung ist, dass sich das nur beeinflussen lässt, indem man das Zeitfenster für das Anlegen ausdehnt.
Anwendungsfall: Mandanten verteilen
Es gibt einige Firmen, die ihren Endkunden mandantenfähige Systeme anbieten. Entweder hosten sie selbst entwickelte Software für viele Endkunden, oder sie tun dasselbe mit einem Open-Source-System (oder einem anderen Fremdsystem). Den Live/Backup-Aufbau lassen wir hier weg, den haben wir schon behandelt und er bringt für diesen Fall nichts Neues. Das Problem hier: Wer ein mandantenfähiges System betreibt, will normalerweise die Zahl der Endkunden klein halten, die ein volumebezogener Ausfall in der Hetzner Cloud trifft. Denn manchmal sind die Wiederherstellungsverfahren nur halbautomatisch oder komplett manuell. Es macht einen großen Unterschied, ob du ein System in weniger als einer Stunde wiederherstellen musst oder vierundzwanzig.
Nehmen wir das schon beschriebene Beispiel. Stell dir vor, fsn1-cloud2-leaf86 fällt aus, mit 24 Volumes dahinter. Für
mich heißt das: 24 Endkunden sind betroffen. Wenn das SLA eine Wiederherstellung in unter einer Stunde vorsieht und nur
eine oder wenige Personen verfügbar sind, wird diese Stunde durch 24 geteilt, allgemein durch 24/Anzahl der Personen.
Im schlimmsten Fall sind das 2,5 Minuten pro System. Selbst wenn eine Stunde für die Wiederherstellung eines einzelnen
Kunden reichlich ist, sind 2,5 Minuten pro Kunde unter Druck, eine Stunde am Stück, für eine einzelne Person
vermutlich kein realistisches SLA.
Der Behelf für diesen Fall ähnelt dem aus dem vorherigen Fall so stark, dass ich ihn dir selbst überlasse. Und wieder hat er genau dieselben Probleme wie im vorherigen Abschnitt. Vielleicht ist die Wahrscheinlichkeit sogar größer, dass die Schleife viele Durchläufe braucht, denn es sind nicht nur zwei Volumes zu verteilen: Bei 200 Kunden sind es 200 Volumes.
Wie geht es weiter?
Diese Untersuchung ist der erste Schritt, um die Ausfallsicherheit der Flotte zu verbessern, für die ich verantwortlich bin. Das Bewusstsein dafür ist der wichtigste Teil des Prozesses. Aber ich weiß auch, dass es nicht der letzte bleiben sollte. Würde ich mit den beschriebenen Behelfen die Flotte auf lauter grüne Rechtecke umbauen, wäre die Handarbeit für das Unternehmen vermutlich nicht zu rechtfertigen.
Mein Plan für die nächste Zeit? Du als Leser bist der wichtigste Teil meines Plans. Ich hoffe, du schreibst mir eine private Nachricht im Hetzner Forum , wenn du ähnliche Probleme hast wie ich. Ich bin außerdem auf dem Hetzner Summit 2026 , wenn du also dort bist und Lust auf ein Gespräch von Angesicht zu Angesicht hast, freue ich mich.
Ich bin dort vermutlich der einzige Pole in einem auffälligen schwarzen T-Shirt, du findest mich also leicht
Quellen
https://docs.hetzner.com/de/general/company-and-policy/slas-cloud/ ↩︎
https://docs.hetzner.com/de/general/infrastructure-and-availability/support-team-opening-hours/ ↩︎
https://forum.hetzner.com/index.php?thread/32581-warum-wartungsarbeiten-an-volumes-nicht-nachts-st%C3%B6rung/&postID=313976#post313976 ↩︎
← Zurück zum Blog